版权信息 书名:机器学习的艺术
ISBN:978-7-115-66679-6
本书由人民邮电出版社发行数字版。版权所有,侵权必究。
您购买的人民邮电出版社电子书仅供您个人使用,未经授权,不得以任何方式复制和传播本书内容。
我们愿意相信读者具有这样的良知和觉悟,与我们共同保护知识产权。
如果购买者有侵权行为,我们可能对该用户实施包括但不限于关闭该帐号等维权措施,并可能追究法律责任。
版 权 著 [美]诺曼·马特洛夫(Norman Matloff)
译 张云翼
责任编辑 郭泳泽
人民邮电出版社出版发行 北京市丰台区成寿寺路11号
邮编 100164 电子邮件 315@ptpress.com.cn
网址 http://www.ptpress.com.cn
读者服务热线: (010)81055410
反盗版热线: (010)81055315
版 权 声 明 Copyright © 2022 by Norman Matloff. Title of English-language original: The Art of Machine Learning: A Hands-on Guide to Machine Learning with R, ISBN 9781718502109, published by No Starch Press Inc. 245 8th Street, San Francisco, California United States 94103. The Simplified Chinese-edition Copyright © 2026 by Posts and Telecom Press Co., Ltd under license by No Starch Press Inc. All rights reserved.
本书简体中文版由No Starch Press Inc.授权人民邮电出版社独家出版。未经出版者书面许可,不得以任何方式复制或抄袭本书内容。
版权所有,侵权必究。
内 容 提 要 机器学习是当下最热门的领域之一。本书是一本基于R语言的机器学习实操指南,通过具体的例子和常见术语解释了机器学习的概念。书中涵盖了机器学习的多个方面,包括所需背景知识、“qe”系列函数、各部分内容架构等。全书介绍了基于近邻的方法(如k 近邻算法)及相关的回归和分类模型、基于树的方法(包括决策树、随机森林、梯度提升等)、基于线性关系的方法、基于划分直线与平面的方法(包括支持向量机和神经网络)等。此外,本书也介绍了一些特定类型的机器学习应用,如图像分类、处理时间序列与文本数据等。
本书适合对机器学习感兴趣,有一定R语言编程基础且具备普通数学知识(熟悉图表和简单代数符号)的读者阅读。
关 于 作 者 Norman Matloff博士是加利福尼亚大学戴维斯分校计算机科学教授,还曾是该校统计学教授。
Matloff博士生于洛杉矶,在东洛杉矶和圣盖博谷长大,拥有加利福尼亚大学洛杉矶分校纯粹数学博士学位。他目前的研究兴趣包括机器学习、公平人工智能、并行处理、统计计算、处理缺失数据的统计方法等。
Matloff博士曾是国际信息处理联合会(International Federation for Information Processing,IFIP)11.3工作组的指定成员,该工作组是联合国下设关注数据库软件安全的国际委员会。他是加利福尼亚大学戴维斯分校统计系的创始成员,并参与了计算机科学系的组建,曾获戴维斯分校范围内的杰出教学奖和杰出公共服务奖。
他曾任R 期刊的主编,是《统计软件》期刊的编委会成员,著有多本教科书。其中基于R语言的著作《统计回归和分类:从线性模型到机器学习》获2017年齐格尔奖。
关于技术审稿人 Ira Sharenow是一名在旧金山湾区工作的高级数据分析师,主要使用R、SQL、Microsoft Excel和Tableau等工具,曾为众多企业提供咨询服务。Sharenow是Norman Matloff上一部著作《统计回归和分类:从线性模型到机器学习》的技术编辑。在业余时间,他喜欢在旧金山湾区的小路上骑行。
致 谢 在我多年的从业生涯中,有许多人影响了我对机器学习和统计问题的思考,我想提及其中几位。
首先,我从我的研究生身上学到了很多,就和他们从我身上学到的东西一样多。我想特别提及最近与我一起进行机器学习工作或在此方面与我互动过的人:Vishal Chakraborty、Yu-Shih Chen、Xi Cheng、Melissa Goh、Rongkui Han、Lan Jiang、Tiffany Jiang、Collin Kennedy、Kenneth Lee、Pooja Rajkumar、Ariel Shin、Robert Tucker、Bochao Xin、Wenxi Zhu,特别是Zhiyuan (Daniel) Guo、Noah Perry、Robin Yancey和 Wenxuan (Allan) Zhao。另外,与Bohdan Khomtchouk(芝加哥大学)、Richard Levenson教授(加利福尼亚大学戴维斯分校医学院)、Pete Mohanty(谷歌)在机器学习问题上的合作也令我非常兴奋。
我要特别感谢Achim Zeileis,他是R软件包partykit的作者之一,该软件包实现了优秀的数据分割方法,他在指导我理解软件包的细节方面帮助良多。Nello Cristianini试阅了我上一部著作《统计回归和分类:从线性模型到机器学习》中支持向量机章节的初稿,并改进了该章主题的呈现方式。
撰写科技书是一种教学形式,因此我要特别感谢已故的Ray Redheffer,他是我在研究生阶段的助教。他非常擅长让学习微积分课程的学生参与一些高级的主题,甚至是做一些简单的证明。他向我传递了明确的信息:即使在讲授初级课程,教师也应该让学生理解他们在做什么,而不是简单地记忆公式和模仿解题步骤。对于一个极具影响力的应用性领域而言,机器学习图书的作者更应该努力让读者理解他们在做什么,而不是仅仅学习库函数的调用形式。
我还想感谢已故的Chuck Stone,他是我洛杉矶的老乡,是我研究生阶段的非正式统计学导师,更是我在旧金山湾区生活了几十年的亲密朋友。他是CART方法的4位初始开发者之一,在k 近邻算法的理论方面做出了开创性贡献。在统计学、气候变化、经济学方面,他很有主见且很直率,这恰恰促使他思考、质疑、捍卫自己的假设。
Ira Sharenow是本书和《统计回归和分类:从线性模型到机器学习》的技术审稿人,感谢他再次作出了杰出的贡献。No Starch出版社的Jill Franklin也同样出色。
我非常感谢No Starch出版社的Bill Pollock帮我出版本书和之前的两部著作。同样感谢这三本书的编辑——刚刚光荣地从CRC出版社退休的John Kimmel。我也要感谢Bill和John的长期鼓励与引导。在这些人的帮助下,我已经搞清楚了写书的技巧。
前 言 机器学习——看到这个科幻感十足的名字,人们可能会以为只有高精尖的专家才能使用这项技术。但事实并非如此。
事实上,机器学习(Machine Learning,ML)很容易用常见术语解释,只要是掌握图表、图像、直线斜率的人,都能够理解并有效地使用 机器学习。当然,“细节决定成败”,我们必须钻研这些细节。机器学习尽管是一种强大的工具,却不像火箭那么复杂。
什么是机器学习 机器学习的核心是预测。患者是否罹患某种疾病?顾客会更换自己的手机套餐吗?一段模糊的录音中到底说了什么?卫星观测到的亮斑是森林火灾抑或只是反射光?
我们根据一个或多个特征 预测结果 。以疾病诊断为例,结果为是否患病,特征可能是血液检测结果、家族病史等。
所有的机器学习都基于一个简单的思路:判断相似度。以手机套餐为例,我们如何预测一位特定顾客的决定?我们需要看一看以前的顾客,并选择一些与这位顾客特征最接近的顾客,例如账单、滞纳记录、年收入等。如果大多数相似顾客没有更换手机套餐,我们就预测这位顾客也会这样。当然,我们不能保证结果最终如此,但这是最佳的猜测。
数学在机器学习理论和实践中担负的角色 许多机器学习都基于漂亮的数学理论,典型的例子是支持向量机(Support Vector Machine,SVM)。但是在将支持向量机用于实际应用的过程中,却极少用到这些理论知识。
毋庸置疑,对机器学习方法的直观 理解,对于在实践中有效利用机器学习至关重要。本书力求在不使用高等数学 的前提下,帮助读者建立敏锐的直观理解。事实上,本书的公式也非常少。
为什么要阅读本书 市面上虽然已经有许多优秀的机器学习图书,但没有一本能够真正帮助读者在现实世界的问题中有效地使用机器学习。许多科技图书的问题是过于注重理论,但我也同样担心应用类图书变得像“食谱”一样,用逐步讲解的方式介绍一个主题。这类图书关注的焦点在于机器学习软件的语法和语义,虽然读者可能很了解这类软件,但仍不能很好地利用 机器学习。
因此,我写作本书的目的如下。
• 我们需要一本使用R语言的书,而不是介绍R语言的书。本书的主题是机器学习,只是以R语言为例,而不是在机器学习中使用R语言。
• 我们需要一本机器学习的书,将机器学习视为艺术 ,而不是科学 。
• 我们需要一本机器学习的书,避免使用高等数学,但同时强调为了高效使用机器学习,我们的确需要理解关于各种机器学习方法“为什么”和“怎么做”的概念。许多“应用类”机器学习图书很少解释这些内容。
以上三点使本书回归“反食谱”主题。
• 我希望机器学习的使用者不仅知道随机森林的定义,更能够令人信服地解释各种超参数如何影响过拟合的问题。机器学习的学习者也应该能够清楚地说明特征工程中“p 值篡改”(p -hacking)这一概念的含义。
• 我们将为读者提供有关机器学习丰富、实用 的方法,包括它们的优缺点、成败原因、注意事项等。我们还将在不太正式的数学基础上,采取实践性手段,用知名软件包处理真实数据集。但我们将以精明的方式进行,成为“有见识的消费者”。
反复出现的主题和章节 一些特别的主题和章节将贯穿本书。
• 偏差(bias)与方差(variance):本书用大量篇幅解释了这两个核心概念在各种机器学习方法中担负的角色。
• 陷阱:许多章节冠以“陷阱”一词,旨在警告读者潜在的问题和避免方法。
所需背景 读者需要怎样的背景才能有效地学习本书呢?
• 不需要机器学习或统计学的先验知识。
• 只需要普通数学知识,本书尽量避免形式化的公式。读者只需要熟悉普通的图表,例如直方图、散点图,了解简单的代数符号,例如直线的斜率,就已经足够了。
• 本书假设读者了解一些R语言编程的知识,例如熟悉向量、因子、数据框、函数等。本书将大量使用R命令行(>提示符,RStudio中的控制台)。不具有R语言背景或希望复习这方面知识的读者,可以浏览GitHub网站上的fasterR教程。
• 确保在计算机上安装R语言和qeML软件包。软件包的最佳安装来源是GitHub,因为能够保证得到的是最新版本。你还需要安装devtools软件包,如果还未安装,请输入下列命令:
install.packages('devtools') 然后输入下列命令以安装qeML软件包:
install_github('https://github.com/matloff/qeML') qeML软件包虽然也会被上传至CRAN R代码库,但不会经常更新。
“qe”系列软件 本书用到的大多数软件来自流行的R软件包,比如:
• e1071;
• gbm;
• glmnet;
• keras;
• randomForest。
读者可以直接使用这些软件包,但为了方便起见,我们通常使用函数包装器,读者可以在qeML软件包中找到它们。这有两大好处:
• 包装器提供了统一的接口;
• 统一的接口也很简单 。
以本书多次使用的共享单车数据集day1为例,要想预测总骑行量tot,可以使用本书介绍的随机森林机器学习算法,调用方法为
qeRF(day1,'tot') 若采用支持向量机,调用方法为
qeSVM(day1,'tot') 太简单了!不需要定义模型的准备性代码,直接调用一个以“qe”开头的函数就行了!前缀qe表示又快又简单(quick and easy)。用户也可以指定某个方法特定的参数,操作起来非常简单。
对于非常高级的应用,本书也会展示如何直接使用这些软件包。
本书架构 第1部分的第1~3章除了介绍本书反复使用的通用概念,也会介绍一些具体的机器学习方法。前面提到机器学习的基本思路是基于相似案例进行预测,这可以通过k 近邻(k -Nearest Neighbor,k NN)算法非常容易地实现。第1部分起到两个作用:首先详细介绍k NN算法,然后介绍所有机器学习方法都会使用的概念,例如超参数 的选择。在k NN算法中,相似样本的数量通常记为k ,这就是一个超参数。对于k NN算法来说,k 的最佳值是多少?它既不能太大也不能太小。超参数的选择是许多机器学习方法的关键,我们将通过k NN算法对比进行介绍。
第2部分将介绍k NN算法的自然拓展——基于树的方法 ,尤其是随机森林 和梯度提升 。这些方法像流程图一样,每次针对一个特征进行提问。在前面提到的疾病诊断例子中,第一个问题可能是患者是否超过50岁,然后是患者的体质指数(Body Mass Index,BMI)是否小于20.2,等等。最终通过这一流程将患者划分为若干组,组内的患者彼此情况都较为相似,因此这种方法与k NN算法有类似之处。但分组形式毕竟与k NN算法有所不同,基于树的方法通常在预测准确度上超过k NN算法,是机器学习的主要工具。
第3部分将讨论基于线性关系的方法。熟悉线性回归分析的读者对此可能有一些了解,但本书并不要求读者具有相关背景。这一部分详细探讨LASSO回归(也称套索回归)和岭回归 ,它们具有缩减经典线性回归估计值的诱人特性。
第4部分介绍基于划分直线与平面的方法。仍以手机套餐为例,假设我们用蓝色标出退出原套餐的顾客,并在同一张图中用红色标出保留原套餐的顾客。我们能否找到一条直线,最大程度地划分这两种颜色的样本点?如果可以的话,我们就可以通过新顾客位于直线的哪一边,来判断他最终的决定。这种思路不仅适用于支持向量机,在一定程度上也适用于著名的机器学习方法——神经网络 。
最后,第5部分介绍一些特定类型的机器学习应用,例如图像分类 。
一般而言,没有任何一种机器学习方法适合所有的应用,但我们希望本书能让读者充分理解各种机器学习方法的异同,并了解各种机器学习方法位于整个机器学习方法图景中的什么位置。
本书配套网站(英文)提供代码、勘误、新的例子等。
补充说明 阅读本书时,记住文字与代码同样重要 。不要只关注代码和图表,没有数学公式、图表和代码的一整页叙述性文字,反而有可能是全书最重要的一页。这是帮助你学习所有机器学习方法中“为什么”的内容,例如为什么选择超参数非常重要。这些文字对你成为具有最强洞察力和预测力的机器学习专家至关重要!
请记住,你所听说过的所有眼花缭乱的机器学习成功案例,都需要数据分析师经过长期、细致的调整和思考才能实现,这需要深入的洞察力,而本书就旨在发展你的这种洞察力。我们尽量不使用数学,这意味着数学让位于描述关键概念的文字。
让我们开始吧,祝你在学习机器学习的道路上一帆风顺!
资源与支持 资源获取 本书提供如下资源:
• 配套代码文件;
• 异步社区7天VIP会员。
要获得以上资源,您可以扫描下方二维码,根据指引领取。
提交勘误 作者、译者和编辑尽最大努力来确保书中内容的准确性,但难免会存在疏漏。欢迎您将发现的问题反馈给我们,帮助我们提升图书的质量。
当您发现错误时,请登录异步社区(www.epubit.com),按书名搜索,进入本书页面,单击“发表勘误”,输入勘误信息,单击“提交勘误”按钮即可(见下图)。本书的作者、译者和编辑会对您提交的勘误信息进行审核,确认并接受后,您将获赠异步社区的100积分。积分可用于在异步社区兑换优惠券、样书或奖品。
与我们联系 我们的联系邮箱是contact@epubit.com.cn。
如果您对本书有任何疑问或建议,请您发邮件给我们,并请在邮件标题中注明本书书名,以便我们更高效地做出反馈。
如果您有兴趣出版图书、录制教学视频,或者参与图书翻译、技术审校等工作,可以发邮件给我们。
如果您所在的学校、培训机构或企业,想批量购买本书或异步社区出版的其他图书,也可以发邮件给我们。
如果您在网上发现有针对异步社区出品图书的各种形式的盗版行为,包括对图书全部或部分内容的非授权传播,请您将怀疑有侵权行为的链接通过邮件发送给我们。您的这一举动是对作译者权益的保护,也是我们持续为您提供有价值的内容的动力之源。
关于异步社区和异步图书 “异步社区” 是由人民邮电出版社创办的IT专业图书社区,于2015年8月上线运营,致力于优质内容的出版和分享,为读者提供高品质的学习内容,为作译者提供专业的出版服务,实现作译者与读者在线交流互动,以及传统出版与数字出版的融合发展。
“异步图书” 是异步社区策划出版的精品IT图书的品牌,依托于人民邮电出版社在计算机图书领域30余年的发展与积淀。异步图书面向IT行业以及各行业使用IT的用户。
第1部分 序言与基于近邻的方法 第1章 回归模型 回归(regression)函数 。这种函数给出一个变量的均值与其他变量的关系,例如儿童的平均体重与年龄的关系。所有机器学习方法都是回归方法 的某种形式,机器学习的过程就是使用我们提供的数据估计回归方程。
我们将介绍第一个机器学习方法:k 近邻(k NN)算法,并将其应用于实际数据中。我们还会穿插介绍一些贯穿全书的概念,例如虚拟变量、过拟合、p 值篡改、“脏”数据等等。我们暂且很简单地介绍这些概念,以使你对我们稍后将详细讨论的内容有一个整体的了解。机器学习直观而连贯,但分阶段学习会更容易掌握。读者朋友请做好准备,你会经常看到“我们暂时只介绍一个方面,后续再介绍更多细节”的叙述。
在开始之前,请确保你的计算机上已安装R语言和软件包qeML、regtools(版本在1.7以上,可运行packageVersion('regtools')进行检查)。本书展示的所有代码都假设用户已通过执行下列代码加载了软件包:
library(regtools)
library(qeML)
下面让我们来看一看第一个示例数据集。
1.1 示例:共享单车数据集在介绍k NN算法前,我们需要一些可用的数据。我们以UC Irvine机器学习库中的共享单车数据集为例。这个数据集包含了Capital Bikeshare系统2011年至2012年每小时和每日的自行车骑行量,也包含天气等其他相关信息。
经数据管理员许可,该数据集已包含在regtools软件包中,名为day。但请注意,我们将使用稍作修改的版本day1(也包含在regtools软件包中),其中数值型天气变量以原始尺度给出,而没有被转换到[0,1]区间。
我们主要希望预测每天的骑行量。
一些术语
假设我们想通过温度和湿度预测骑行量,标准的机器学习术语将用于预测的变量称为特征 (feature ),在本例中即为温度和湿度。
想要预测的变量如果是数值型的,例如骑行量,则没有特别的机器学习术语,称为结果 (outcome )变量。而想要预测的变量如果是R因子,即分类变量,则称为标签 (label )。
举例而言,本书后面将分析人类脊椎疾病的数据集,结果变量有三种类型:正常(记作NO)、盘疝(记作DH)、滑椎(记作SL)。数据集的该列表示患者的类型属于NO、DH还是SL,该列就是标签列。
我们的数据集,如day1,称为训练集 (training set )。我们要用它预测未来的情况,特征可知而结果未知,我们要预测的就是未知的结果。
1.1.1 载入数据 数据以逐小时和逐日形式给出,regtools软件包中的格式为后者。用下列代码载入数据:
> data(day1) 对于任何数据集,最好都先浏览一下。数据集中包含什么数据?它们是什么类型,数值型还是R因子?有哪些典型取值?一种方法是使用R语言的head()函数查看前几条数据:
> head(day1)
  instant     dteday season yr mnth holiday
1       1 2011-01-01      1  0    1       0
2       2 2011-01-02      1  0    1       0
3       3 2011-01-03      1  0    1       0
4       4 2011-01-04      1  0    1       0
5       5 2011-01-05      1  0    1       0
6       6 2011-01-06      1  0    1       0
  weekday workingday weathersit     temp
1       6          0          2 8.175849
2       0          0          2 9.083466
3       1          1          1 1.229108
4       2          1          1 1.400000
5       3          1          1 2.666979
6       4          1          1 1.604356
      atemp      hum windspeed casual registered
1  7.999250 0.805833 10.749882    331        654
2  7.346774 0.696087 16.652113    131        670
3 -3.499270 0.437273 16.636703    120       1229
4 -1.999948 0.590435 10.739832    108       1454
5 -0.868180 0.436957 12.522300     82       1518
6 -0.608206 0.518261  6.000868     88       1518
   tot
1  985
2  801
3 1349
4 1562
5 1600
6 1606
> nrow(day1)
[1] 731
我们可以看到,数据共731行(即731天),每条数据包含日期、性质(例如是否为工作日)以及天气条件(例如温度、湿度)。最后三列为临时用户、注册用户和他们合计的骑行量。
你可以使用?day1命令获得更多信息。
1.1.2 未来前瞻 我们即将对数据进行实际分析,现在只是预览。假设我们希望根据特定的天气条件等预测明天的总骑行量等信息,应该如何用k NN算法实现呢?
我们需要搜索数据,查找天气条件等变量相同或相似的数据,然后取这些数据骑行量的平均值,就可以作为明天总骑行量的预测值。
是不是太简单了?其实并非如此,前面的描述是很准确的。当然,“细节决定成败”,但过程的确很简单。在此之前,我们需要解决一些一般性问题。
1.2 机器学习与预测机器学习方法基本上就是关于预测的算法。在我们深入第一个机器学习方法之前,我们应该明确“预测”的含义。
以共享单车数据集为例,每天一早,共享单车的管理员可能希望预测当日的总骑行量。他可以分析特征之间的关系,例如天气状况如何,当天是工作日还是节假日等。当然,预测不是完美的,但如果能与实际数值大致相符,也能大有帮助,比如这可以帮助管理员决定要给多少自行车打气以供使用(更高级的情形是预测每个站点的自行车需求量,从而帮助管理员据此分配自行车)。
1.2.1 预测过去、现在和未来 著名棒球运动员Yogi Berra曾说:“预测很难,尤其是预测未来。”在机器学习中,预测并非仅指对未来的预测,也可以是对现在甚至过去的预测。例如研究人员想要估计18世纪初的工人平均工资,医生想通过血液检查和症状等判断患者是否罹患某种疾病,这些都是对现在或过去而非未来的预测。因此在机器学习领域谈论“预测”时,不要过度关注“预”的文义。
1.2.2 对比统计学中的预测与机器学习中的预测 一个常见的误解是,机器学习关注预测,而统计学关注推断 ,例如置信区间、假设检验等。但其实预测是统计学不可分割的一部分。
统计学界与机器学习界时常发生良性竞争,甚至都有自己单独的术语(见附录B)。的确,统计学家有时会使用统计学习 (statistical learning )这一术语代指机器学习领域的一些相同方法!
我曾经是统计学教授,但在计算机科学系度过了大部分职业生涯,所以我在这两个领域都有涉足。我主要会用计算机术语介绍机器学习方法,但也会提供一些统计学原理方面的见解。
历史注解
本书介绍的许多方法最初是由统计学界开发的,但已成为机器学习的支柱,包括k NN算法、决策树或随机森林、逻辑斯谛回归、L1/L2收缩等。这些方法都是从19世纪提出的线性模型发展而来的,但统计学家认为线性模型不足以解决某些应用问题,相关的思考使人们对限制性假设更少的方法产生了兴趣,从而首先发展出k NN算法,后来又发展出其他的技术。
另一方面,支持向量机(Support Vector Machine,SVM)和神经网络也是两种主要的机器学习方法,它们完全诞生于统计学界之外的计算机科学界(还有一种方法称为自适应提升,始于计算机科学界,但统计学界和计算机科学界对比都有所贡献)。这两种方法的动机与统计学完全无关。我们经常听到的神经网络,最初是一种理解人脑工作模式的方法。支持向量机则可简单地用计算机算法术语来描述:给定两个类别的数据点集,如何找出一个划分这两类数据的最佳直线或平面?
1.3 k 近邻算法简介本节主要介绍k NN算法 。这可以说是很经典古老的机器学习方法了,可以追溯至20世纪50年代,但在今天仍有广泛应用,尤其是在特征数量不太多的应用中(稍后你就会明白原因了)。
1.3.1 使用k 近邻算法预测单车骑行量 我们首先研究如何利用单个特征——温度,使用k 近邻算法预测单车骑行量。假设天气预报说当天的温度为28度,我们如何利用28这个数字和过去的单车骑行量数据集(即训练集),来预测当天的骑行量呢?没有机器学习知识背景的人可能会说,看一看我们的所有数据,把温度最接近28度的记录取出来(因为恰为28度的数据可能没有或很少),然后求这些天的平均骑行量,就可以用得到的数值预测当天的骑行量。
事实上,这种直觉是正确的!这其实也是许多常见机器学习方法的基础,我们在1.6节讨论回归函数时还会说到。现在暂且认为k NN算法就是在类似的记录(即临近的数据点)上取平均的算法。参数k 表示我们要选取的“邻居”数量。比如我们可以选择过去5个温度最接近28度的记录,求出平均值,从而预测未来温度为28度的某天的骑行量。
本章我们将学习使用k 近邻算法的“qe”系列实现:qeKNN()。但现在我们先“手动”执行k 近邻算法,以更好地理解这一方法。
1.3.1.1 R语言提取子集方法回顾 在展示代码前,我们先来复习R语言的一些知识。在R语言中,#引导注释,即用于解释代码,而非代码本身的一部分。本书使用行内注释来解释代码的功能。
在后续步骤中,你还需要知道如何在R语言中提取子集,以下列代码片段为例:
> x <- c(5,12,13,8,88)
> x[c(2,4,5)]
[1] 12 8 88 表达式x[c(2,4,5)]从x中提取了第2、4、5个元素,其中2、4、5称为下标 或索引 。
1.3.1.2 第一个预测 下面是手动执行k 近邻算法的小例子:
> data(day1)
> tmps <- day1$temp
> dists <- abs(tmps - 28) # distances of the temps to 28
> do5 <- order(dists)[1:5] # which are the 5 closest?
> dists[do5] # and how close are they?
[1] 0.005849 0.033349 0.045000 0.045000 0.084151
两个数值之间的距离等于它们之差的绝对值,例如|25−32|=7,所以25到32的距离为7,我们在以上代码中调用了绝对值函数abs()。R语言的order()函数与sort()函数类似,但返回的是排序后的下标。例如:
> x <- c(12,5,8,88,13)
> order(x)
[1] 2 3 1 5 4
输出的2、3等表示x中的最小值是x[2],第二小的值是x[3],等等。而下列代码会将day1数据集中温度最接近28度的5行数据的索引存入do5。
> do5 <- order(dists)[1:5] # which are the 5 closest? 在本例中,这些温度都很接近28度,最远的也只相差0.08度。
这几天的骑行量如何呢?
> day1$tot[do5]
[1] 7175 4780 4326 5687 3974
我们再对上述数值取平均:
> mean(day1$tot[do5])
[1] 5188.4
这样我们就能预测温度为28度的某天的骑行量了,约有5200人会使用这项服务。
当然这里还有许多待解决的问题,尤其是:为什么取最接近28度的5天?5天会不会太少,会不会不足以做出精确的预测?这是机器学习的核心问题,我们将在1.7节继续讨论。
1.4 虚拟变量与分类变量无论是处理这个数据集,还是执行其他机器学习任务,你都需要理解数据中表示虚拟变量 (dummy variable)的列。虚拟变量的取值只有0和1,取决于数据是否满足某个条件。例如在workingday这一列中,0表示“否”(即当天不是工作日),1表示“是”(即当天是工作日)。2011-01-05这一天的workingday取值为1,说明是工作日。
虚拟变量有时也称指示变量 (indicator variable),因为它们“指示”了某个条件是否满足。机器学习领域的人也时常称其为独热编码 (one-hot coding)。
共享单车数据集中还有分类变量mnth和weekday。此外,wethersit包含4种类型(1=晴朗,2=雾或多云,3=小雪或小雨,4=大雪、冰雹或暴雨),也是分类变量。
虚拟变量常用于编码分类数据。在市场研究中,居民的区域(城市、郊区、农村)是影响因素之一。在原始数据中,它们可能编码为1、2、3,这一编码是随意的,农村并不表示3倍的城市,但是机器学习方法可能会这样解读,我们并不想要这样的结果。
本书和机器学习领域采用的解决方法是使用虚拟变量。我们可以设置表示城市和郊区的虚拟变量(1=是,0=否),城市和郊区均取0则表示农村,所以农村不需要再设虚拟变量(如果设置则可能导致技术问题,本书不打算探讨)。当然,选择这两个虚拟变量并无特殊考虑。我们也可以选择城市和农村的虚拟变量设置均取0表示郊区。
在本章中,我们的应用聚焦于数值型结果变量,例如共享单车数据集中的骑行量。但在很多应用中,结果变量可能是分类数据,比如前面说到的脊椎疾病诊断案例。这种任务称为分类任务 ,变量Y 是分类数据,它必须转换为虚拟变量。
幸运的是,多数机器学习软件包,包括qeML,都自动进行了虚拟变量的转换,我们稍后就会说到。
1.5 使用qeKNN()进行分析我们现在更加了解了k 近邻算法背后的原理,现在让我们尝试使用qeKNN()函数来执行一些k 近邻分析。我们在前言中提到,本书使用“qe”系列的封装函数,对于k 近邻算法来说,则是qeKNN()函数。它封装了regtools软件包中的基本k 近邻函数kNN(),或者说为其提供了接口。qeKNN()会调用kNN(),但是更加简单方便。
在开始分析之前,我们首先介绍符号X 、Y ,以便说明我们在做些什么。请注意,这对于后续章节而言非常重要。
特征X 与结果Y
在机器学习和统计学领域,常常使用以下非正式的简写指代特征和结果。
• 传统上,人们常常用X 代指特征,用Y 代指要预测的结果。
• X 是数据框或矩阵中的若干列。如果我们要通过温度和湿度预测骑行量,则X 就包括温度和湿度两列数据;而Y 则是骑行量这一列。
在二分类任务中,Y 一般就是一个虚拟变量,这一列取值非0即1;在多分类任务中,Y 则是若干列,每一列都代表一个虚拟变量。在R语言中,Y 也可以等价地用R因子表示,此时Y 只占一列。
此外,你还需要掌握以下标准记号。
• X 的行数,即数据点的数量,通常记为n 。
• X 的列数,即特征的数量,通常记为p 。
这些记号只是为了使用方便,毕竟用X 代指一个特征集合要简便很多。X 、Y、n 、p 会贯穿本书(也会在别处出现,因为这是机器学习领域的标准符号),所以一定要好好记牢。
1.5.1 利用qeKNN()预测骑行量 在共享单车案例中,我们需要预测任意一天的总骑行量。我们首先只使用表示是否为工作日的虚拟变量和数值型天气变量。
从day1数据框中提取这些列,它们是第8列和第10~13列,另外第16列是结果变量——总骑行量(tot)。因此我们可以用下列代码进行数据提取:
day1[,c(8,10:13,16)] 这样就能将所需的几列提取出来。
注意: 也可以在R语言中用列名代替列编号进行数据提取。
day1[c('workingday','temp','atemp','hum','windspeed','tot')] 也可以使用tidyverse软件包和data.table。数据框的列索引是比较容易使用的数值,但列名可能更加清晰。
我在前言中已经指出,这是一本以R语言作为工具的机器学习图书,而不是一本在机器学习中应用R语言的图书。因此如何使用R语言操作数据并非本书关注的焦点,你可以随意采用自己喜欢的方法来得到同样的结果。
现在我们已经取得子数据框,按照惯例还是先浏览一下。
> day1 <- day1[,c(8,10:13,16)]
> head(day1)
  workingday     temp     atemp      hum windspeed  tot
1          0 8.175849  7.999250 0.805833 10.749882  985
2          0 9.083466  7.346774 0.696087 16.652113  801
3          1 1.229108 -3.499270 0.437273 16.636703 1349
4          1 1.400000 -1.999948 0.590435 10.739832 1562
5          1 2.666979 -0.868180 0.436957 12.522300 1600
6          1 1.604356 -0.608206 0.518261  6.000868 1606
下面我们试着进行预测。假设你是管理员,今天是工作日,气温12.8度,体感温度11.8度,湿度23%,风速5英里/时(1英里约合1.6千米)。你要如何预测骑行量呢?
所有“qe”系列函数的调用方法都很简单:
qeSomeMLmethod(your_data_frame, Y_name, options_if_any) 本例中用到的参数是k ,即邻居的数量,我们取为5(若调用时不指定k 的值,则默认值为25)。
> knnout <- qeKNN(day1,'tot',k=5) # fit the kNN model
holdout set has 73 cases 我们使用了k 近邻算法,邻居数为5,Y (即结果)是数据框day1中的变量tot。我们稍后将讨论保留集,现在暂且不论。
我们将qeKNN()的输出存入knnout变量(当然也可以任意取名)。这其实包含了许多信息,但我们暂时不做深入。函数qeKNN()做了预处理工作,使得我们可以使用knnout进行未来的预测。
预测做得怎么样呢?“qe”系列函数的一般形式同样非常易用:
predict(output_from_qe_function, new_case) 作为共享单车业务的管理员,假设已知当天为工作日,气温、体感温度、湿度、风速对应的数值分别为12.8、11.8、0.23、5,则我们的预测结果为
> today <- data.frame(workingday=1, temp=12.8, atemp=11.8, hum=0.23, windspeed=5)
> predict(knnout,today) # predict new case
     [,1]
[1,] 6321
我们将knnout作为参数输入predict()函数,同时指定要预测的数据点today,就能得出骑行量的预测值约为6300。注意参数today也是一个数据框,其列名与原始数据集day1的列名相同,许多R语言的机器学习软件包都要求这样做,以便将预测点的列名与训练集相匹配。
注意: 如果再次运行上述代码,则有可能得到不同的输出,这是因为保留集的选择是随机的。有一种方法可以使结果标准化,让不同的人都能得到相同的结果,我们将在1.12.3节解释。
让我们再做一个预测,假设风速参数的值为18,其余参数的值不变:
> anotherday <- today
> anotherday$windspeed <- 18
> predict(knnout,anotherday)
     [,1]
[1,] 5000
人们肯定不想在大风中骑车。
predict()函数的第二个参数可以是任意具有相同列名的数据框,比如上面的anotherday。你可以同时进行两个预测:
> predict(knnout,rbind(today,anotherday))
     [,1] [,2]
[1,] 6321 5000 在1.8节,我们将通过分析另一个数据集,深入研究k 近邻算法。
技术说明:predict()与泛型函数
qeKNN()与predict()函数可以联用,在“qe”系列函数中,所有函数都以类似的方法配对,这是R语言中的一个常用技巧。
虽然所有函数看上去都共享同一个 predict()函数,但其实每个函数都有各自的预测函数,例如qeKNN()的预测函数就是predict.qeKNN()。在R语言中,像predict()这样的函数称为泛型函数 (generic function)。这一语句对调用进行了调度 (dispatch),也就是将原始调用转发到能进行分析的具体函数。因此在qeKNN()创建的对象上调用predict()函数时,该调用实际上会被转发到predict.qeKNN()函数。
R语言有许多泛型函数,其中很多你可能已经在用了,只是不知道它们是泛型函数。比如print()、plot()、summary()等。
1.6 回归函数:机器学习的基础要理解机器学习方法,你需要知道机器“学习”到了什么 ,答案是回归函数 ,这直接或间接地成为机器学习的基础(通常是间接的)。回归函数在其他变量给定的情况下,给出一个变量的均值。下面具体解释一下。
注意: 回归函数是通用的统计学和机器学习术语,读者可能在统计学课程中学习过线性回归的概念,回归函数的概念则要广泛得多。
回到共享单车案例,假设我们将气温相近的几天骑行量的平均值,作为气温28度的某天骑行量的预测值。如果我们要预测气温为15度的某天的总骑行量,则可以通过气温为15度或接近15度的几天骑行量的平均值来进行。将回归函数记为r (),则骑行量可表示为r (28)、r (15)等。
我们将 r ()称为骑行量对气温的回归函数。它的确是一个函数,对于任意输入(气温值),我们都能得到一个输出(对应的平均骑行量),然后我们利用这个输出进行预测。例如,要预测气温为15度的某天的总骑行量,我们就用r (15)作为预测值。
但不像我们熟悉的sqrt()那样,这是一个形式未知的函数,因此我们需要利用训练数据推断函数值。在机器学习的语境中,这称作利用数据“学习”了这个函数,这就是机器学习中“学习”一词的来历(“机器”一词仅仅表示我们使用计算机或算法来进行学习)。比如在上面的例子中,我们通过对气温接近28度的几天骑行量求平均,学习 了 r (28)的取值。因此学习 一词也反映为“训练数据 ”这一术语中的“训练 ”。
习惯上,我们用“帽子”记号表示估计值,因此我们将r ()的估计值记为
回归函数也称条件均值 。在利用气温预测骑行量的案例中,r (28)就是在给定气温为28度的条件 下的平均骑行量。这个子群体的均值与总体的均值很不相同。
下面对要点进行总结:
• 回归函数r ()给出结果变量的均值与特征之间的函数关系;
• 我们使用训练数据估计r (),并将估计结果记为
• 我们基于
所有函数都需要参数,回归函数的参数就是特征。比如,我们可以将湿度作为第二个特征。要预测温度为28度、湿度为0.51的某天的骑行量,我们可以使用温度和湿度参数值分别接近28和0.51的几天骑行量的平均值。利用回归函数的符号可记为r (28, 0.51);而在1.5.1节的例子中,预测值为r (1, 12.8, 11.8, 0.23, 5)。
前面已经提到,回归函数直接或间接地成为所有预测性机器学习方法的基础,我们会在本书中反复提及这一概念。
1.7 偏差-方差权衡在前言中,我们曾告诉读者:没有数学公式、图表、代码的一整页叙述性文字,反而有可能是全书最重要的一页。
本节就是很好的例证,因为偏差-方差权衡 (bias-variance trade-off)是机器学习领域的著名主题之一。这是机器学习的核心话题,我们将在第3章深入探讨,但你应该从一开始就对它有所了解,所以我们先进行一下简单介绍。
这个问题可以体现为k 的取值是大一点还是小一点。较大的k 值会带来较小的方差和较大的偏差,而较小的k 值则具有相反的效果。让我们看看这是怎么一回事。
1.7.1 选举投票类比 首先我们用选举投票进行类比。在选举中,投票数可用于估计候选人的受欢迎程度。一位分析师从所有电话号码中随机抽样,并收集接听电话者的意见。
假设我们关注某位候选人C在总体中的支持率p 。因为我们只有来自总体的一组样本,所以我们只能利用这组样本的支持率p 。相应地,投票结果则伴随着一个误差范围 (margin of error),这表明给出的支持率p 的一个估计值(学过统计学的读者可能知道,误差范围就是95%置信区间的半径)。
误差范围是估计值精确度的指标,它表征了抽样变异性。误差范围越大,若更换另一组样本,p 的估计值的变化也越大。在样本容量较小的条件下,如果民意调查员使用另一组电话号码的样本进行采访,则p 的估计值可能有很大差异。当然,民意调查员可能也不打算再做第二次抽样,但抽样变异性能告诉我们用p 的估计值有多可靠。误差范围反映了抽样变异性,如果误差范围太大,就说明样本容量太小了。
抽样变异性是其中的关键因素,称为方差 ,在选举投票实例中,它可以通过误差范围求出。
另外,这一过程也可能出现偏差的问题。假设分析人员拿到的是有线电话而不是手机的电话号码清单,那么因为许多人尤其是年轻人可能根本没有有线电话,结果就很可能出现偏差。
1.7.2 回到机器学习 回到机器学习,考虑1.5.1节的共享单车案例,我们想把预测值作为
我们可以将每天骑行量的数据看作过去、现在和未来总体中的一组样本。利用k 近邻算法(或其他机器学习方法),我们只能得到真实总体回归函数换言之,这体现了方差的问题。
另一方面,在1.3.1节的例子中,若只取此时将产生偏差问题。
总结一下,较大的k 值可以减小方差,但可能增大偏差。我们希望找到一个最佳的k 值,不能太大,也不能太小。
不过还要注意,算法所需的计算时间和存储容量也是重要考虑因素。如果最佳方法需要的运行时间过长,或者要占用太多的内存,则我们可能需要选择其他方法。
1.8 示例:mlb数据集为了巩固你对qeKNN()的理解,同时介绍本书反复用到的另一个实例,我们选择对mlb数据集也执行类似的操作。这个数据集由加利福尼亚大学洛杉矶分校统计学系提供,其中记录了美国职业棒球联盟选手的身高(单位:英寸,1英寸合2.54厘米)和体重(单位:磅,1磅约合0.454千克)。这一数据集包含在regtools软件包中。
首先我们浏览一下数据,以便了解要处理的内容:
> data(mlb)
> head(mlb)
             Name  Team       Position Height
1   Adam_Donachie   BAL        Catcher     74
2       Paul_Bako   BAL        Catcher     74
3 Ramon_Hernandez   BAL        Catcher     72
4    Kevin_Millar   BAL  First_Baseman     72
5     Chris_Gomez   BAL  First_Baseman     73
6   Brian_Roberts   BAL Second_Baseman     69
  Weight   Age PosCategory
1    180 22.99     Catcher
2    215 34.69     Catcher
3    210 30.78     Catcher
4    210 35.43   Infielder
5    188 35.71   Infielder
6    176 29.39   Infielder
假设一位新选手的身高数据为72,年龄数据为24,我们来预测一下他的体重。
> w <- mlb[,c(4:6)] # extract height, weight, and age
> z <- qeKNN(w,'Weight') # fit kNN model
holdout set has 101 rows
> predict(z,data.frame(Height=72,Age=24))
       [,1]
[1,] 182.56
再次注意,我们用mlb数据集拟合了模型,因此需要将预测点(72,24)组织为与其格式相同的数据框。
1.9 k 近邻算法与分类特征在前面的棒球选手实例中,身高、年龄特征都是数值型的。但如果我们增加一个分类特征Position(站位)呢?k 近邻算法是基于距离的,而特征必须是数值型才能计算距离。我们如何在k 近邻算法中处理非数值型特征呢?
当然,答案是分类变量(即R因子)都应当转换为虚拟变量。我们可以使用regtools软件包中的函数factorToDummies()来完成转换。不过“qe”系列函数会在必要时自动进行转换,所以我们不需要自行将Position转换为虚拟变量。qeKNN()函数还会在输出中进行记录,后续在利用predict()进行预测时,也会进行相同的转换。
例如,假设我们想在身高、年龄之外,利用分类特征Position预测新选手的体重:
> knnout1 <- qeKNN(mlb[,3:6],'Weight',25) # extract Position, Height, Age
> predict(knnout1,data.frame(Height=72,Age=24,Position='Catcher'))
     [,1]
[1,] 197
在第一次预测中,我们没有使用Position,得到预测值约为183。但如果我们知道这位新选手是捕手,则我们可以看到预测值在本例中变为197。这很合理,为了守住本垒,捕手往往身材魁梧。
“qe”系列函数根据R因子的数据类型识别分类特征。在本例中,Position的确是R因子。前面已经提到,qeKNN()与predict.qeKNN()会帮助我们自动将其转换为虚拟变量,这给我们带来了很大的便利。
一般来说,分类数据在数据框中就已经表达为R因子了。但在一些案例中,分类特征却是用数值型编码进行记录的。此时需要使用as.factor()将这些特征转换为R因子的形式。
1.10 归一化许多机器学习方法都会提到的话题是数据的归一化 [1]
让我们回到棒球选手实例。假设有两位选手,其中一位的体重数据为70、年龄数据为24,另一位的体重数据为72、年龄数据为30。在代数中,它们可以视为两个有序数对,而它们之间的距离就是点(70,24)和点(72,30)在平面上的距离:
在k 近邻算法中,距离就是这样计算的。但如果我们将身高的单位转换为米,而将年龄的单位转换为月呢?此时身高的数值要除以39.37,而年龄的数值要乘以12:
> sqrt((70/39.37-72/39.37)^2 + (12 * 24-12 * 30)^2)
[1] 72.00002 这样就造成了一个问题:年龄会在计算中处于主导地位,身高的影响微乎其微。然而身高是影响体重的重要因素,因此这种改变会降低预测能力。
解决问题的方案是去掉英寸、米等单位,称为归一化 。要想将数据归一化,可以首先减去均值,使所有特征的均值都变成0,这一步骤称为中心化 (centering)。然后将每个特征除以各自的标准差,即进行归一化 ,使标准差都变为1。这样所有特征都是无量纲且彼此相称的(一般而言,在进行归一化时,我们会先进行中心化,整个过程可简单地统称为归一化)。
为了巩固这一概念,在学生时代,你的老师可能会这样对考生分数进行转换:“要想得到A,你的分数需要超过均值1.5个标准差。”老师就是首先将考试分数减去平均分,然后除以标准差。R函数scale()可以帮我们进行这一操作,但为了展示过程,我们可以自己进行这样的操作:
> ht <- mlb$Height
> ht <- (ht - mean(ht)) / sd(ht)
> mlb$Height <- ht 为完成这一过程,qeKNN()函数提供了一个参数scaleX,默认值为TRUE,因此在我们前面的k 近邻实例中,都已自动进行数据的归一化。对于数据的每个X 列(即特征列),qeKNN()都会调用scale()进行归一化(事实上,我们调用一次scale()就能对所有变量进行归一化)。
当然,我们在预测新的样本时,也要对X 值进行归一化,即除以相应的标准差。“qe”系列函数会记录这一操作,并在匹配的predict()函数中执行。
注意: 对于所有值都相同的列,不能使用scale()函数,因为它的标准差为0。我们可以调用regtools软件包中的函数constCols(),这个函数可以给出数据框中所有值都相同的列。
在共享单车案例中,为了讲授方便,day1使用了未归一化的数据。而在该数据集的“官方”版本day中,数据虽然已进行归一化,但方法有所差异:数据归一化的结果是使其落入[0,1]区间。一种方法如下:
相较于scale()函数,这种方法的好处是能产生有界变量 ,即所有数值都在0和1之间。而scale()函数给出的变量位于区间
regtools软件包中的mmscale()函数可以利用上述方法将数据映射到[0,1]区间。一个小例子如下:
> x <- data.frame(u=3:5,v=c(12,5,13))
> x
  u v
1 3 12
2  4 5
3 5 13
> mmscale(x)
     [,1] [,2]
[1,]  0.0 0.875
[2,]  0.5 0.000
[3,]  1.0 1.000
u列的均值为4,最小值和最大值分别为3和5。以第2行的4为例,它将被转换为(4−3)/(5−3)=1/2。你可以看到,所有结果都在[0,1]区间且无量纲,即不带英寸、月等单位。
1.11 选择超参数在前言中,我们曾提到k 近邻算法中的k 是一个超参数 (hyperparameter),或称为调节参数 (tuning parameter),即由用户选择,但会影响预测能力的参数。1.7节也提到,k 的值必须仔细选择,不大不小才能取得最佳效果。
寻找最佳k 值很有挑战性,但幸运的是,k 近邻算法只有一个超参数。你会在本书的后续章节中看到,大多数机器学习方法有若干超参数,而在本书不会介绍的高级方法中,可能有十多个甚至更多的超参数。选择“正确的”超参数取值组合非常困难,即使只选择一个超参数的合适取值也不容易。
下面我们简单了解选择超参数的一些方法,第3章再深入探讨。对于超参数的选择,我们会在本章多花一些时间讨论,因为这个问题会在全书和你的整个机器学习生涯中频繁出现。
1.11.1 对训练数据进行预测 几乎所有选择超参数的方法都需要利用预测新样本的方法对模型进行测试,而最基本的形式是反过来预测我们原先的训练数据。这听起来有点奇怪,既然已经知道了骑行量,为什么还要预测呢?这其中的道理是,我们可以尝试不同的k 值,看一看哪一个能最好地预测我们已知的数据,这个k 值以后就可以用于对新的X 数据进行预测了。
这种做法并不理想,在实践中经常需要改进。下面让我们先通过一个例子看看这样做有什么问题。我们想预测day1数据集中的第3个数据点,k 选为最小的可能取值1。
> kno <- qeKNN(day1,'tot',1)
> datapoint3X <- day1[3,-6] # remote Y value
> predict(kno,datapoint3X)
     [,1]
[1,] 1349
> day1[3,6]
[1] 1349 我们的预测完全正确!但请等一下,这似乎有点可疑,事实也的确如此。最接近第3个数据点(即数据中的第3行)的就是它本身!它到自己的距离是0。类似地,最接近第8行数据的就是第8行,最接近第56行数据的也就是第56行……我们当然会得到100%正确的结果,只取最接近的一个邻居,事实上只是对Y 值进行了复制而已。利用同样的分析,当k =5时,我们也会高估预测的准确度,因为在这5个邻居中,其中一个就是原本的数据点,这会导致预测上的偏差。
我们从中获得的经验是,在评估给定k 值的预测准确度时,应该在另一个数据集上预测,而不能使用拟合模型时用过的数据集。但你可能会反对说,我们只有一个数据集,如何获取另一个数据集以评估预测准确度呢?这就引出了1.12节的话题——留出集。
1.12 留出集前面已经提到,评估模型的预测准确度时,我们需要在“新鲜”数据上做测试,而不能用拟合模型时用过的数据。但如果我们没有新数据该怎么办呢?解决这一问题的关键,就是本节将要介绍的留出集 (holdout set)和交叉验证 (cross-validation)法 ,这是机器学习的核心概念,也会在本书中反复提及。
在day1数据集的731个数据点中,我们可以随机选出若干数据点,比如100个数据点,作为留出集 或测试集 (test set),其余631个数据点则暂时作为训练集。我们用训练集拟合模型,而用留出集测试预测的效果,此时留出集就是未用于训练的“新鲜”数据(在本例中,留出集的容量为73,因为默认占整个数据集的大约10%)。
从技术上来说,如果用整个数据集拟合模型,则对未来的预测准确度最好,此时可设置holdout=NULL。但在初期探索阶段,理解模型对新数据的效果如何是很重要的。因此最好在探索阶段设置留出集,而在选定超参数之后,再用整个数据集重新对模型进行拟合。
在选择留出集之前,若想评估预测的质量,我们还需要评价预测准确度的指标。
1.12.1 损失函数 对于留出集中的数据点,我们可以求出预测值和实际值之差的绝对值,再对所有留出集中的数值取平均,即可得到平均绝对误差(Mean Absolute Prediction Error,MAPE),这是损失函数的一个例子,也是预测质量的评价指标之一。我们可以使用MAPE作为指标,该指标越小越好。
另一个常用的损失函数是均方误差(Mean Squared Prediction Error,MSPE),它对预测误差的平方取平均值。MSPE更常用,但我比较喜欢用MAPE,因为MSPE过度强调了较大的误差。假设我们要预测mlb数据集中的体重,而误差分别为12和15。这两个数值相差不大,但其平方144和225却相差很大。
在分类应用中,最常用的损失函数就是分类错误的总概率。要对留出集中的每个Y 进行预测,用预测错误的次数除以留出集的容量即可。
1.12.2 “qe”系列函数中的留出集 “qe”系列函数能自动执行上述过程,求出MAPE或总体分类错误率,并将结果体现在输出testAcc中。根据我们是否将Y (调用“qe”系列函数时的第2个参数)指定为R因子,这些函数就可以判断这个问题是否为分类任务。若是分类任务,则计算分类错误率而非MAPE。
我们再次以共享单车数据集为例,展示qeKNN()函数如何自动计算MAPE:
> knnout <- qeKNN(day1,'tot',5)
holdout set has 73 rows
> knnout$testAcc
[1] 1203.644
利用5个最近的邻居得出的平均预测误差约为1200。这个估计不算太好,但比下面的情况好一些。
假设我们无法获取天气等信息,如何预测骑行量呢?一个很自然的想法是直接取所有数据的平均值:
> meanTot <- mean(day1$tot)
> meanTot
[1] 4504.349
换言之,对于任何一天,包括要预测的那一天,我们都预测约有4500位骑行者。采用这种策略的效果如何呢?
> mean(abs(day1$tot - meanTot))
[1] 1581.793
如果对每一天都用总体平均骑行量进行预测,则平均预测误差会达到约1600。而使用天气信息、是否为工作日等信息进行预测,可将MAPE降至1200。
有没有比k =5更好的取值呢?我们试一试10、25:
> qeKNN(day1,'tot',10)$testAcc
holdout set has 73 rows
[1] 1127.333
> qeKNN(day1,'tot',25)$testAcc
holdout set has 73 rows
[1] 1131.108 在我们测试的取值中,k =10似乎是效果最好的,但我们也必须认识到留出集的选择是随机的。事实上,最好对每个k 值都在不同的留出集上进行测试,这是1.12.3节所要讨论的话题。
1.12.3 使用交叉验证法的动机 调用qeKNN()函数时,程序会自动计算MAPE,但需要注意的是,软件对留出集的选择是随机的。留出集的容量仅为73,样本量略小,想象一下,民意调查员只取73个样本并不合适。因此在利用不同的留出集计算MAPE时,抽样变异性 会很大。解决这一问题的办法是采用交叉验证法 ,即取多个留出集上MAPE的平均值。
为了说明抽样变异性,我们多次执行同样的代码:
> qeKNN(day1,'tot',10)$testAcc
holdout set has 73 rows
[1] 1094.211
> qeKNN(day1,'tot',10)$testAcc
holdout set has 73 rows
[1] 1157.5
可以看到,一个MAPE值并不可靠,样本量73太小了。我们在这个话题上还有许多问题需要讨论,第3章将继续探讨。但现在已经可以说明,我们应该选择多个留出集进行交叉验证,并对得到的testAcc值取平均。
顺便一提,我们可以使用set.seed()函数对R语言的随机数生成器进行控制:
> set.seed(9999)
> qeKNN(day1,'tot',10)$testAcc
holdout set has 73 rows
[1] 1210.373
> qeKNN(day1,'tot',10)$testAcc
holdout set has 73 rows
[1] 1090.622
> set.seed(9999) # try it again
> qeKNN(day1,'tot',10)$testAcc
holdout set has 73 rows
[1] 1210.373
> qeKNN(day1,'tot',10)$testAcc
holdout set has 73 rows
[1] 1090.622
我们会在本书中经常做这样的处理。这会设置特定的随机数序列,以便读者运行代码和验证结果。若采用同样的随机数种子,例如这里的9999,则产生的训练集和留出集将与本例相同(我只是随意选择了9999这个数字,并无特殊理由)。
显然,生成多个留出集可得到更准确的结果,故应对MAPE取平均。这种方法称为交叉验证法 ,我们会在第3章继续深入探讨。
1.12.4 超参数、数据集大小与特征数量 k 近邻算法中的k 值存在权衡取舍。
• 若取k =5,则仅对5个数据点取平均,样本似乎太少了。这会产生方差的问题,对给定的X 值求5个Y 值的平均值,若换用另一组样本,则结果会有较大差异。
• 若取k =50,则一些邻居可能与要预测的点相距过远,失去了预测的意义。
例如在共享单车案例中,假设要预测气温20度的一天骑行量,天气较为舒适。而训练集中可能存在气温40度的炎热天气,将其纳入考虑会导致预测值偏小,产生偏差问题。
此时需要做权衡取舍,我们既希望k 值大一点以降低方差,又希望k 值小一点以规避偏差的风险。然而,如果共享单车数据集有n =73 000个数据点,而非731个,情况又会怎样呢?此时第50个最近的邻居也许也很接近预测点,这样就不会有偏差的问题了。我们可以使用更大的k 值来控制方差,换言之,若其他条件不变,n 越大,则k 也可以越大。
但这仍然没有告诉我们如何确定k 的取值,我们会在第3章和第4章回到这一话题,但你在早期就应该注意这一问题。
关于特征的数量p ,类似的结论如下:若其他条件不变,p 越大,则k 也应当越大。
这个结论不如与n 的关系那么直观,但大概如此。更多的特征意味着数据点间距离的变异性更大,从而使得预测的方差增加。为应对这一问题,k 的值应当增大。
1.13 陷阱:p 值篡改与超参数的选择在机器学习以外的领域,p 值篡改 是这样一种大型研究中的陷阱。假设研究人员在研究基因对某种效应的影响,而研究中涉及许多基因。即使没有一个基因具有真实的影响,但由于抽样变异性,有可能其中一个基因会恰巧看起来具有“显著”的影响。我们暂时不会细致介绍如何解决这一问题,但你应该从一开始就对这一问题有所了解。
p 值篡改在机器学习的超参数选择中也具有重大影响。假设机器学习方法中有4个超参数,若对其中的每个超参数都尝试10个候选值,则有104 =10 000种候选组合。即使各种组合的效果相同,也可能出现某个组合恰巧具有非常好的MAPE值。看起来“最好”的超参数也许只是一种幻觉。
regtools软件包中的函数fineTuning()在选择最佳超参数组合时,会采取一系列步骤来避免p 值篡改问题,我们将在第7章继续探讨。
1.14 陷阱:数据中的长期时间趋势在进入第2章之前,我们还需要介绍在使用本章所讲的机器学习方法时,可能影响预测质量的三个陷阱:脏数据、数据缺失以及数据中的长期时间趋势。我们首先介绍数据中的长期时间趋势这一陷阱。
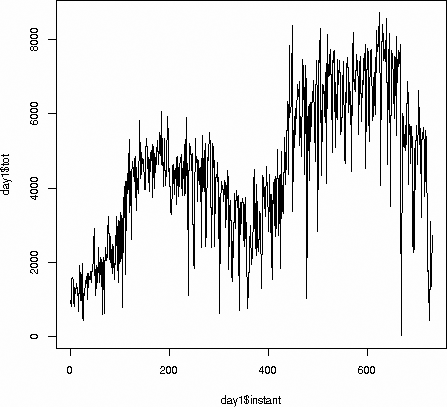
在使用MLB数据的几个实验中,我们发现最佳MAPE值可能在1100左右。这个误差很大,但我们并没有用到全部数据。回顾1.1.1节的共享单车数据集,其中有一些关于时间的数据:日期、季节、年、月。为了研究时间数据是否会改进MAPE,我们用骑行量对时间作图(数据已按时间排序。)
> plot(day1$tot,type='l') # plotting type is 'l', lines between points 结果如图1-1所示。显然,其中既有季节性趋势(低值约间隔一年),也有整体的上升趋势。共享单车服务似乎随着时间而越来越受欢迎。分析数据随时间变化的统计学技巧称为时间序列方法 ,这种方法也大量出现在机器学习领域。我们会在第13章继续介绍它,但在不使用新工具的条件下也可以先做些尝试。
图1-1 共享单车数据中的长期时间趋势
共享单车数据的第1列instant表示日期,第一天的值为1,第二天的值为2,以此类推,最后一天的值为731。
我们将instant加入特征集,在1.5.1节我们曾用下列方法选择若干列:
> day1[,c(8,10:13,16)] 当时我们想要探索的特征位于第8列、第10~13列和第16列。现在我们想加入第1列的instant:
> data(day1)
> day2 <- day1[,c(1,8,10:13,16)]
> kno <- qeKNN(day2,'tot',k=5) # rerun kNN on the new data
holdout set has 73 rows
> kno$testAcc
[1] 662.9836
MAPE值降至约663。
在使用k 近邻算法或本书介绍的其他机器学习方法时,注意所研究的现象可能随时间而变化,时间可能是重要因素。在一些案例中,时间甚至可能没有明确的变量,而是隐藏在记录的顺序中。如果不对此进行探索,可能就会导致预测质量大幅下降,因此请留意这一潜在的陷阱。
1.15 陷阱:脏数据除了数据中的长期时间趋势,你还可能遇到脏数据的问题。以2011年1月1日的共享单车数据为例。
> head(day1)
  instant     dteday season yr mnth holiday
1       1 2011-01-01      1  0    1       0
根据holiday列,1月1日不是节假日,但1月1日是美国的法定假日。另外,虽然weathersit分类变量有4种可能的取值,但实际上只有3种取值:
> table(day1$weathersit)

  1   2  3
463 247 21
数据中的错误很常见,当然它们也是阻碍我们进行良好分析的障碍。我们在第5章会深入讨论纽约出租车的数据,其中记录了起点与终点的位置、行程时间等。根据数据记录,其中一个终点的位置竟然在南极洲!
处理新数据集时,分析人员应该进行数据探索,例如利用前面介绍的hist()和table()函数。你还应该注意多变量异常值 (multivariate outlier)的问题,即数据的每一个分量都不是极端值,但组合起来却不正常。例如,假设某人的身高为74英寸(约188厘米),年龄为6岁。虽然单看身高和年龄都没问题(假设数据中有各年龄段的人群),但二者的组合却很可疑。对于这种情况,k 近邻算法是一个很有用的工具!74英寸高的6岁儿童所对应的数据点与其他数据点相距很远,从而暴露这一数据所存在的问题。
但是检测数据异常并没有程序化的方法。这也反映了我们所强调的机器学习的整体本质,没有所谓的魔法“菜单”。这是统计学的高级主题,超出了本书的讨论范围。
1.16 陷阱:数据缺失在R语言中,NA值表示数据不可用,即数据缺失。数据集常常包含NA值,甚至可能有很多。我们如何应对?
研究缺失数据的书有很多,我们无法在此深入介绍,但我们可以简单讨论一种常用的方法——个案剔除 (listwise deletion)法 ,并至少介绍一下该方法存在的问题。
假设人群数据集中有年龄、性别、受教育年限等数据。若某人的年龄数据缺失,而其余数据完整,则该方法会直接跳过年龄数据。这种方法存在两个问题。
• 如果特征的数量很多,则许多数据都会存在NA值,这种方法会丢掉过多宝贵的数据。
• 跳过具有NA值的数据可能造成偏差。以调查数据为例,拒绝回答某些问题的人和同意回答的人可能存在差异,这会影响预测的准确度。
注意,如果缺失值是用数值编码的,则应将该值转换为NA值。
与脏数据类似,处理缺失数据的方法十分依赖个人经验。你可以学习一些工具并逐渐形成自己的方法,这很大程度上因人而异。“CRAN Task View”系列教程中就包含处理缺失数据的内容。
1.17 直接使用k 近邻算法的代码在前言中,我们提到本书大部分代码使用了机器学习方法专用的常见R软件包。“qe”系列封装器对这些软件包进行了封装,并提供统一、简单的接口。当然,你也可以直接使用原始代码。
这样做的原因之一是,标准R软件包的高级选项可能未在封装中暴露出来。另外,如果只是进行一次预测,直接调用qeKNN()可能更快,这与其他“qe”系列函数不同。
大多数应用可能并不需要专业化的调用,但为了满足读者的好奇心,本书会展示原始函数的用法。我们无法在此展示高级选项的用法,因为它们数量繁多且常常与高级概念相关。我们会简单介绍如何直接调用原始函数来实现前面的例子。
下面是k 近邻算法的代码,qeKNN()函数封装了regtools::kNN()函数,其参数如下:
> library(regtools)
> args(kNN)
function (x, y, newx = x, kmax, scaleX = TRUE, PCAcomps = 0,
    expandVars = NULL, expandVals = NULL, smoothingFtn = mean,
    allK = FALSE, leave1out = FALSE, classif = FALSE, startAt1 = TRUE,
saveNhbrs = FALSE, savedNhbrs = NULL) 其中x 和y 就是X 和Y 的取值,newx表示想要预测的X ,kmax就是k 值。
让我们重新执行1.8节的步骤:
> x <- mlb[,c(4,6)] # height, age
> y <- mlb[,5] # weight
> newx <- c(72,24) # ht, age of new player to be predicted re weight
> kmax <- 25 # k
> knnout <- kNN(x,y,newx,kmax)
> knnout$regests # predicted value
[1] 183.76
注意,模型的拟合与预测已合并为一个步骤,如有必要,预测也可以暂缓。
此处的预测与之前的预测稍有差异,此处自动产生了留出集。如果我们不想形成留出集,则可以得到与之前相同的结果:
> kno <- qeKNN(mlb[,4:6],'Weight',k=25,holdout=NULL)
> predict(kno,data.frame(Height=72,Age=24))
       [,1]
[1,] 183.76
输入?kNN(而不是?knn)可获取kNN()的更多信息。
1.18 结论我们的起步不错!你应该已经理解了k 近邻算法和一些机器学习的通用概念,比如回归函数,k 近邻算法如何估计回归函数,偏差-方差权衡的基本概念,超参数的影响,以及如何使用留出集在权衡中找到平衡点。
你掌握的工具已经足以让你自行进行一些数据分析实验了。请尽情尝试吧!
第2章将介绍分类应用中的问题。


 。
 来估计候选人C在总体中的支持率p。相应地,投票结果则伴随着一个
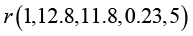 的估计值,这样实际的预测值
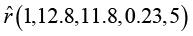 就是它的一个估计。
 的估计值
 。只利用最近的
 个邻居进行估计,仅适用于样本量很小的情况。想象一下民意调查员只抽取5个投票者的样本会怎样!若采用另一组骑行量的样本,则仍用最接近的几天进行预测的结果可能很不相同。
 个邻居,我们就有可能取到离预测点很远的点,它们与要预测的点并不相似。
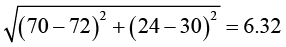
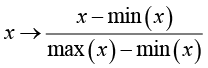
 ,标准差较小的变量在归一化后可能变得很大,从而会对分析产生较大影响。